Arquitectura de software: integración IA
Integrar inteligencia artificial en una aplicación puede parecer fácil. El usuario escribe una instrucción. La aplicación se la envía a un modelo. El modelo responde. En pocas horas ya existe algo que entiende lenguaje natural y produce resultados bastante impresionantes.
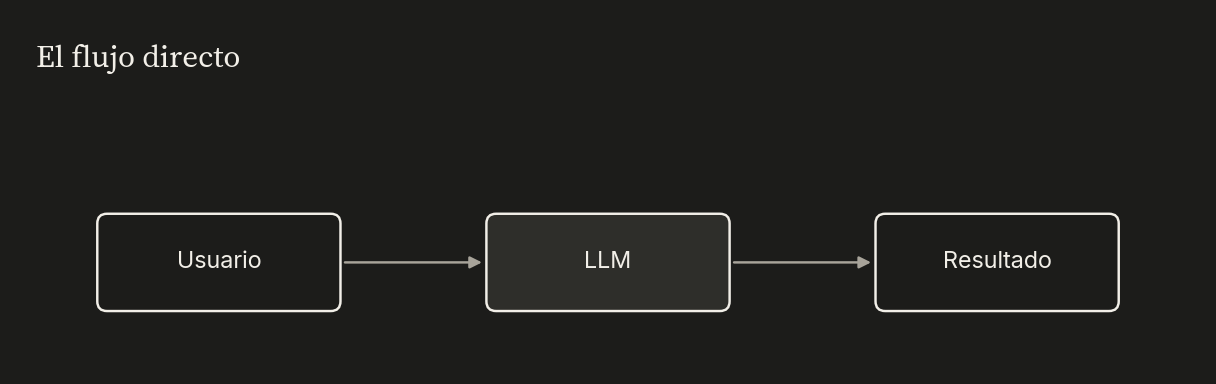
Para una demo quizás alcanza. El problema empieza cuando intentamos construir un producto sobre ese flujo. Ahí aparecen tres dificultades bastante concretas: el costo de procesar grandes cantidades de contexto, la inconsistencia entre resultados y la dificultad para convertir las mejoras en capacidades permanentes del software.
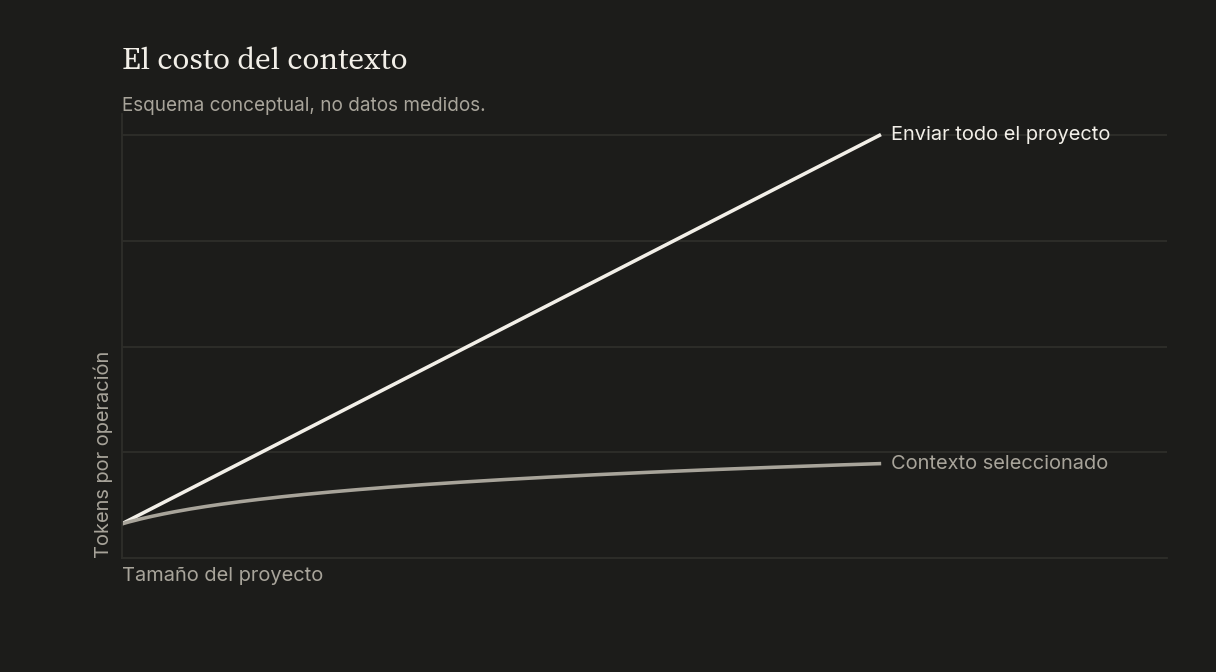
Una respuesta puede ser excelente y la siguiente, frente a una situación parecida, tomar otro camino. Podemos corregir el prompt, agregar más instrucciones y utilizar un modelo más potente. El resultado mejora. También crecen el contexto, el costo y la dependencia de que el modelo vuelva a interpretar correctamente las mismas reglas en cada operación.
La pregunta de arquitectura aparece bastante rápido:
¿Qué debería resolver la IA y qué debería quedar definido dentro del software?
La hipótesis que estoy explorando es simple: usar el LLM para entender intenciones, trabajar con ambigüedad y proponer alternativas; utilizar software determinístico para conservar el estado, ejecutar cálculos y aplicar reglas.
No se trata de ponerle límites arbitrarios a la IA. Se trata de darle un sistema sólido sobre el cual trabajar.
El problema de pedirle todo al modelo (LLM)
Los modelos de lenguaje son buenos interpretando pedidos que el software tradicional encontraría incómodos. Una persona puede decir:
“Quiero que esto tenga más espacio, pero sin modificar demasiado el resto.”
No hay parámetros exactos. Hay una intención que depende del contexto y probablemente admita varias soluciones. Un LLM puede entender el pedido, identificar qué información falta y proponer alternativas razonables.
La situación cambia cuando llega el momento de ejecutar la modificación.
Para hacerlo, el sistema necesita conocer el estado actual del proyecto, respetar sus relaciones, aplicar restricciones y comprobar que el resultado siga siendo válido. Si le entregamos todas estas responsabilidades al LLM, cada operación exige reconstruir una parte importante del razonamiento.
El modelo vuelve a leer reglas que ya leyó. Vuelve a interpretar relaciones que el sistema ya conocía. Repite cálculos y devuelve una nueva representación del resultado. Utilizamos tokens otra vez para que vuelva a pensar algo que, en muchos casos, ya podríamos haber convertido en lógica.
Además, un LLM es probabilístico. Puede responder de manera diferente ante entradas similares. Esa flexibilidad resulta valiosa cuando hay que interpretar o explorar. Para calcular una cantidad, mantener una relación geométrica o verificar un límite, preferiría una función bastante menos imaginativa.
Tres dolores del enfoque directo
El primer problema es el costo.
A medida que un proyecto crece, también lo hace la información necesaria para comprenderlo. Si enviamos su estado completo, el historial de la conversación, las reglas del dominio y la documentación en cada consulta, el consumo de tokens escala junto con el producto.
El costo no depende solamente del precio de la API. También incluye latencia, reintentos, correcciones y supervisión. Un modelo económico que obliga a repetir una operación tres veces puede resultar bastante caro.
El segundo problema es la confiabilidad.
Que una respuesta tenga el formato esperado no significa que su contenido sea correcto. El modelo puede generar una operación perfectamente estructurada y, aun así, haber interpretado mal la intención, utilizado una referencia equivocada o ignorado una restricción. Para una conversación, esto puede ser tolerable. Para un software que modifica datos, realiza cálculos o toma acciones, no.
El tercer problema es la dificultad para construir sobre los resultados.
Podemos mejorar un prompt después de detectar un error. Pero esa mejora sigue siendo una instrucción que el modelo deberá interpretar en cada ejecución futura. No necesariamente se convierte en una capacidad estable y comprobable del producto.
Si descubrimos que una determinada condición siempre debe cumplirse, resulta más valioso transformarla en una regla ejecutable. Desde ese momento, cada operación puede validarse de la misma manera. La mejora queda incorporada al sistema.
Ahí aparece una diferencia importante entre obtener una buena respuesta y construir software.
IA como capa de interpretación
La arquitectura que estoy explorando ubica al LLM en una posición específica: entre la intención humana y las capacidades del sistema.
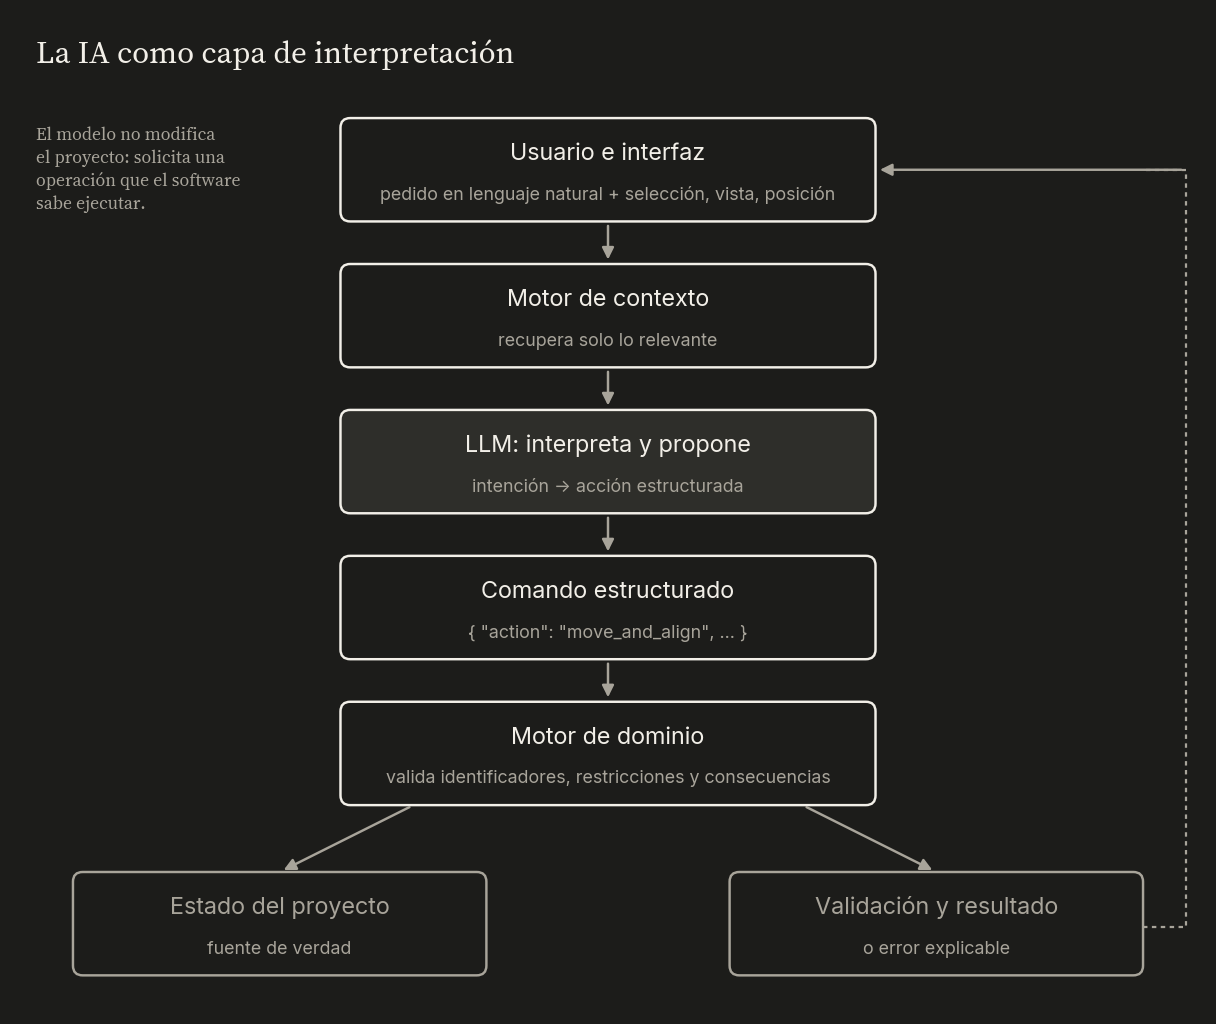
El usuario puede expresarse de forma flexible. La interfaz agrega información que ya conoce: qué elemento está seleccionado, qué vista está abierta o dónde ocurrió la interacción.
El motor de contexto recupera los datos relevantes. El LLM interpreta la intención y propone una acción estructurada. El motor de dominio valida esa acción, ejecuta la lógica y actualiza el estado.
Por ejemplo, el modelo podría producir algo parecido a esto:
{
  "action": "move_and_align",
  "target_id": "element_142",
  "reference_id": "element_139",
  "direction": "left"
}
El modelo no modifica directamente el proyecto. Solicita una operación que el software sabe ejecutar.
Los límites y alcances deben estar claramente establecidos en el sistema. La IA puede equivocarse al elegir la acción, pero no tiene libertad ilimitada para alterar el sistema. La capa de comandos define qué operaciones existen, qué parámetros aceptan y qué permisos requieren.
Después entra el motor de dominio: comprueba identificadores, aplica restricciones, calcula consecuencias y decide si la modificación es válida. Si lo es, actualiza el estado. Si no, devuelve un error para que el usuario siga ajustando definiciones o el sistema aplique algún criterio para resolver el error.
Un JSON válido no garantiza una decisión sensata. Solo nos da una frontera donde empezar a controlarla.
El software necesita su propia memoria
El estado de una aplicación no debería vivir en el historial del chat.
La conversación contiene pedidos, respuestas, pruebas, errores y decisiones que quizás ya fueron descartadas. Si el modelo tiene que reconstruir desde ahí qué versión sigue vigente, la probabilidad de error aumenta con cada interacción.
La aplicación necesita un modelo de dominio propio: una representación estructurada de las entidades, sus propiedades y sus relaciones. Este modelo funciona como fuente de verdad. La interfaz lo muestra. El motor de dominio lo modifica. La IA consulta solamente la parte que necesita.
Esto también permite construir sobre el trabajo anterior. Si una regla modifica varias relaciones, el resultado queda almacenado en el estado del proyecto. La siguiente operación comienza desde ese estado validado; no depende de que el modelo recuerde cómo llegó hasta allí.
La conversación ayuda a interpretar el proceso. No tiene que cargar con el proyecto entero sobre los hombros.
Dar contexto no significa enviar todo
Una IA trabaja mejor cuando tiene contexto. De ahí es fácil saltar a una conclusión bastante cara: mandemos todo.
Si el usuario está modificando un elemento, probablemente el modelo necesite conocer sus propiedades, los objetos relacionados y las restricciones que afectan esa operación. No necesita recibir todas las entidades del proyecto.
Para eso hace falta un motor de contexto: una capa que seleccione la información relevante antes de llamar al modelo.
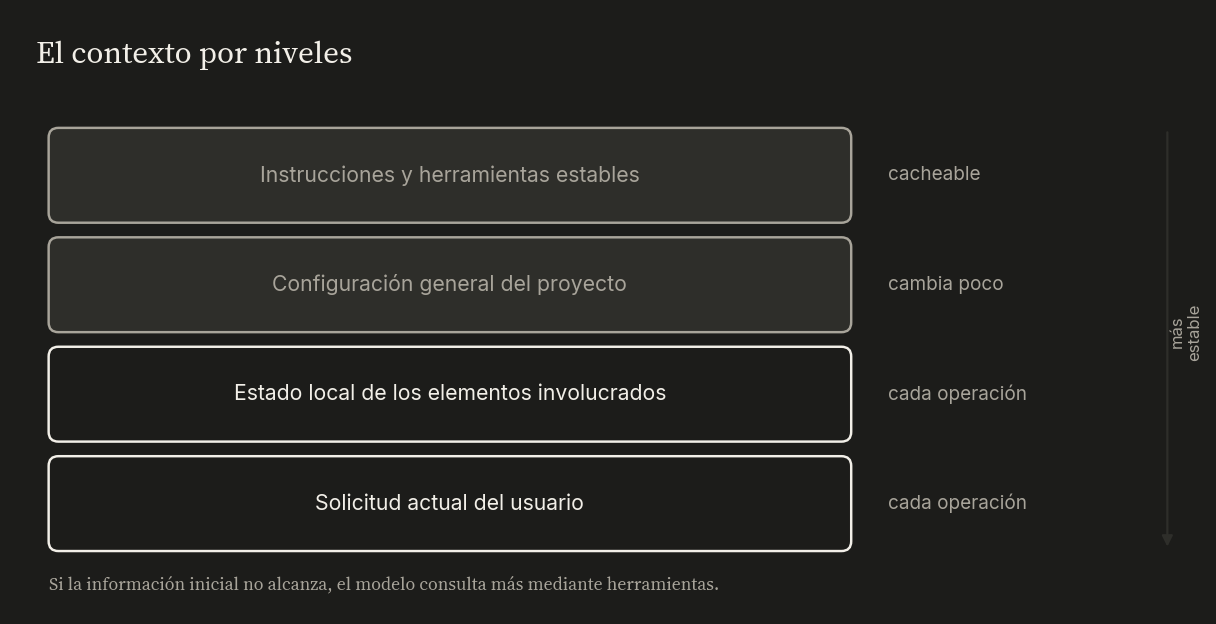
Las partes estables pueden reutilizarse o almacenarse en caché cuando la infraestructura lo permite. Las partes dinámicas se construyen para cada operación.
Si la información inicial no alcanza, el modelo puede consultar más mediante herramientas. El contexto se amplía a medida que la tarea lo exige, en lugar de viajar completo por las dudas. Esto reduce tokens, pero también ruido.
Convertir conocimiento en lógica
Una aplicación especializada puede acceder a manuales, normas o documentación mediante búsqueda y recuperación de información. El modelo recibe los fragmentos pertinentes y los utiliza para responder o explicar una decisión.
Eso sirve para trabajar con conocimiento extenso o cambiante. Pero leer una regla y ejecutar una regla son cosas distintas.
Si una condición puede expresarse de esta forma:
if condition_z:
    assert x >= y
conviene evaluar si debería formar parte del motor de dominio.
Formalizarla requiere trabajo. Hay que entender cuándo aplica, contemplar excepciones y mantenerla actualizada. A cambio, obtenemos una validación reproducible, testeable y mucho más barata de ejecutar.
La base de conocimiento conserva las fuentes y explicaciones. El motor de reglas contiene aquello que el sistema ya aprendió a comprobar.
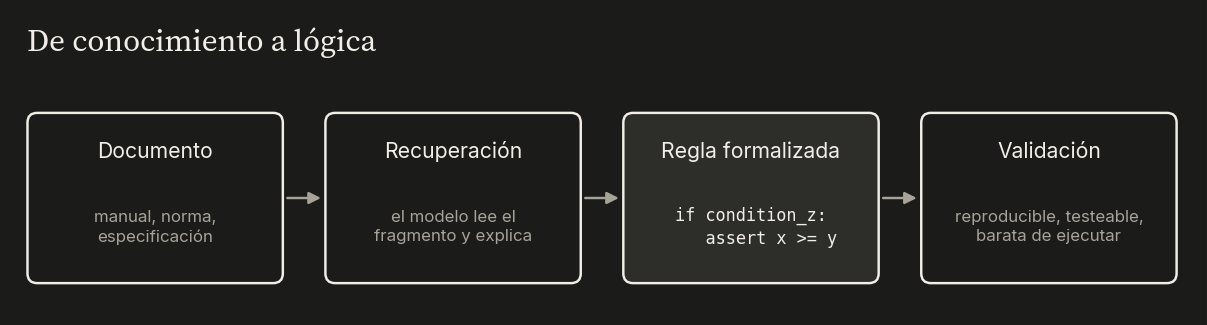
Con cada regla formalizada, el producto acumula capacidad real. La mejora deja de depender de que el modelo interprete correctamente el mismo párrafo en todas las consultas futuras.
Ese proceso me parece central para construir aplicaciones especializadas con IA: transformar progresivamente conocimiento del dominio en estructura computable.
Usar modelos distintos para trabajos distintos
No todas las solicitudes necesitan el mismo nivel de razonamiento.
Una operación habitual puede resolverse mediante un comando directo o un modelo pequeño. Una petición ambigua, que exige comparar alternativas y consultar varias fuentes, puede justificar un modelo más capaz.
La arquitectura debería permitir ese enrutamiento.
Primero puede intentar reconocer operaciones conocidas. Después utilizar un modelo rápido para interpretar tareas simples. Solo cuando la complejidad lo requiere, escala a un modelo más potente.
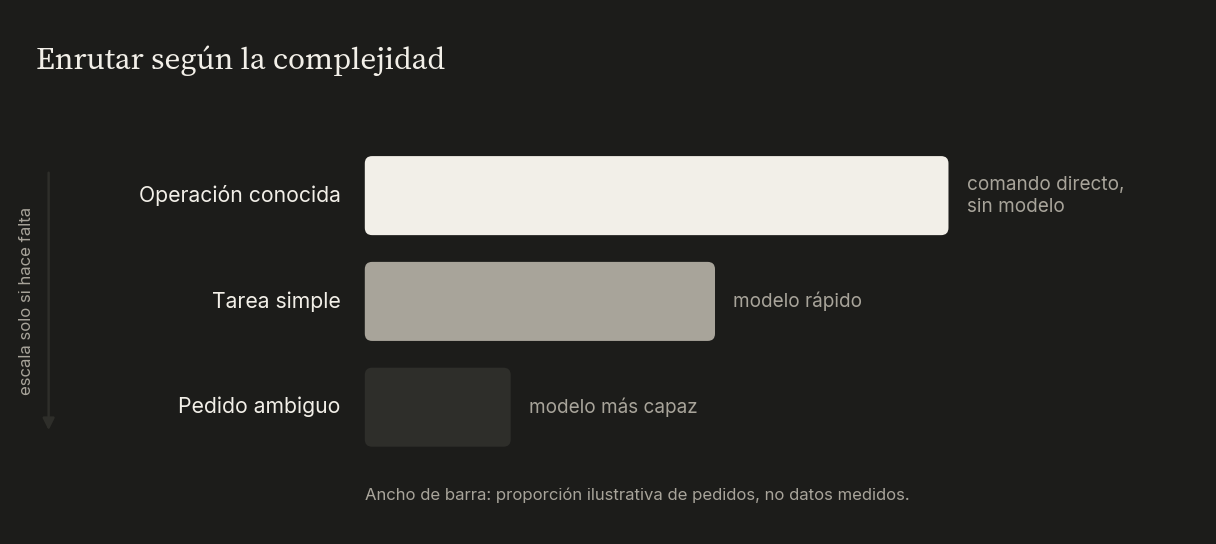
El objetivo no es elegir siempre la opción más barata. Es reducir el costo de completar correctamente una tarea. Una respuesta incorrecta genera nuevas llamadas, correcciones y tiempo perdido.
También conviene registrar qué ocurrió: qué pidió el usuario, qué contexto recibió el modelo, qué acción propuso, qué validaciones se aplicaron y cuál fue el resultado.
Sin ese registro, cuando algo sale mal es difícil saber si falló la interpretación, la selección de contexto, una herramienta o una regla del dominio.
Una mejora que se acumula
Lo que más me interesa de esta arquitectura es que permite aprovechar dos tipos de software muy diferentes.
El LLM trabaja bien con lenguaje, ambigüedad e intención. Puede entender pedidos incompletos, recuperar información y explorar soluciones.
El software determinístico trabaja bien con estado, cálculos, restricciones y repetición. Puede ejecutar la misma regla miles de veces sin tener que redescubrirla.
La combinación busca resolver los tres dolores iniciales.
Reduce costos porque el modelo recibe menos contexto y participa solamente cuando aporta valor. Aumenta la confiabilidad porque las acciones pasan por comandos, validaciones y reglas. Y permite construir sobre los resultados porque el conocimiento formalizado se acumula dentro del producto.
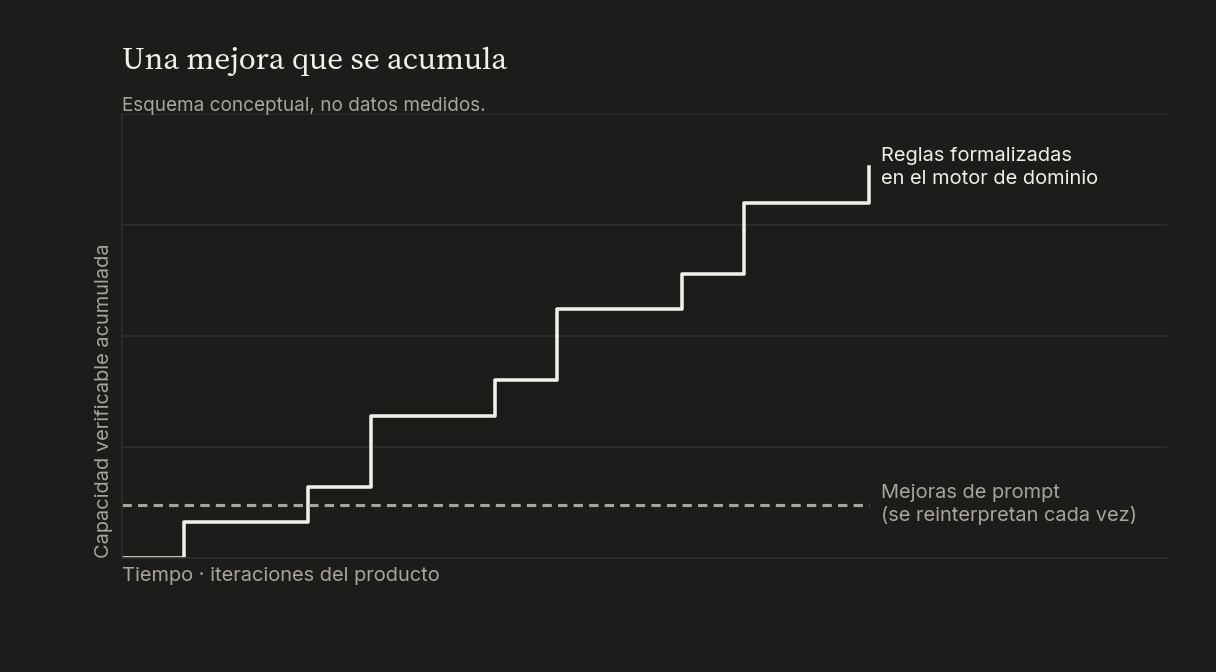
La profundidad de una aplicación con IA probablemente no esté en la cantidad de cosas que le pedimos al modelo. Puede estar en todo lo que construimos debajo para que sus capacidades sean útiles, consistentes y económicas.
Un modelo cada vez más capaz mejora la capa de interpretación. El motor de dominio, los datos y las reglas se van acumulando y permanecen.
La IA entiende qué queremos hacer. El software se ocupa de generar un producto de calidad.